70人参与 • 2026-08-19 • Ajax
目前 80% 的网站都使用了ajax技术,那么传统的爬虫通过 html 来获取数据就不行了,总结一下 ajax 相关知识。
前端开发的三大核心基础是 html、css 和 javascript。
本质上是 标记语言(markup language),通过标签描述页面元素。
常见标签:
<h1>标题</h1>
<p>段落</p>
<a href="https://example.com" rel="external nofollow" >链接</a>
<img src="image.jpg">
<div></div>
页面结构示例:
<!doctype html>
<html>
<head>
  <title>网页标题</title>
</head>
<body>
  <h1>hello world</h1>
  <p>这是一个网页</p>
</body>
</html>
主要负责:
示例
h1 {
  color: red;
  font-size: 30px;
}
html + css
<h1 class="title">hello</h1>
.title{
  color: blue;
}负责:
示例:
点击按钮改变文字
<button onclick="changetext()">点击</button>
<p id="text">hello</p>
function changetext(){
  document.getelementbyid("text").innertext="hello js";
}
最后再举一个三者的例子
一个按钮:
html   定义按钮
css    让按钮变漂亮
js     点击按钮触发逻辑
代码:
<button id="btn">点击</button>

<style>
button{
  background:red;
  color:white;
}
</style>

<script>
document.getelementbyid("btn").onclick=function(){
  alert("点击成功");
}
</script>
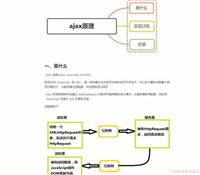
全称:asynchronous javascript and xml(异步 javascript 和 xml)。它不是一种新的编程语言,而是一种 web 开发技术组合,用于让网页在不重新加载整个页面的情况下与服务器交换数据并更新部分页面内容。
⚠️ 补充:虽然名字里带 xml,但现在实际开发中几乎都用 json(更轻量、易读)代替 xml,ajax 只是沿用了历史名称。
举例
这些全是 ajax。
传统网页请求流程:
ajax 的流程:
// 1. 创建 xmlhttprequest 对象(核心)
const xhr = new xmlhttprequest();

// 2. 配置请求:请求方式、请求地址、是否异步(默认true)
xhr.open('get', 'https://jsonplaceholder.typicode.com/todos/1', true);

// 3. 监听请求状态变化(核心)
xhr.onreadystatechange = function() {
  // readystate=4 表示请求完成,status=200 表示响应成功
  if (xhr.readystate === 4 && xhr.status === 200) {
    // 4. 处理服务器返回的数据(json格式)
    const data = json.parse(xhr.responsetext);
    console.log('请求成功,返回数据:', data);
    // 5. 局部更新页面(比如把数据显示到页面)
    document.getelementbyid('result').innerhtml = `
      <p>任务标题:${data.title}</p>
      <p>是否完成:${data.completed ? '是' : '否'}</p>
    `;
  }
};

// 4. 发送请求
xhr.send();

// 页面中需要有一个容器来显示结果
// <div id="result"></div>
原生 fetch 是 es6+ 新增的 ajax 方案,语法更简洁,支持 promise:
// 发起 get 请求
fetch('https://jsonplaceholder.typicode.com/todos/1')
  // 第一步:处理响应,转为 json 格式
  .then(response => {
    if (!response.ok) {
      throw new error('请求失败:' + response.status);
    }
    return response.json();
  })
  // 第二步:使用数据,局部更新页面
  .then(data => {
    console.log('fetch请求成功:', data);
    document.getelementbyid('result').innerhtml = `
      <p>任务id:${data.id}</p>
      <p>任务标题:${data.title}</p>
    `;
  })
  // 捕获请求异常
  .catch(error => {
    console.error('请求出错:', error);
    document.getelementbyid('result').innerhtml = '<p>请求失败,请重试</p>';
  });
ajax 对爬虫的影响,本质是改变了“数据出现的位置和时机”。
传统爬虫思路:请求 url → 拿到 html → 用 xpath / 正则提取数据。
ajax 页面:你直接请求 url,拿到的 html 是空壳、没有数据,数据全是 js 后来异步加载的。
判断标准:
<div id="app"></div>)→ 确认是 js 通过 ajax 加载数据小技巧:
document 就是你最开始请求的那个网页 html
浏览器先把整个页面的骨架(html、head、body、空的 div)一次性下载完,这一步叫 document 加载完成。
右键页面 → 查看网页源代码(ctrl+u)
搜索你肉眼看到的数据(如商品标题、文章内容)
如果 network 里又有 xhr json → 100% 是 ajax
步骤:
打开浏览器
f12 → network
找 fetch/xhr 请求
复制接口
判断 api 是否可以直接爬
检查 request headers
重点看:
cookie
token
sign
authorization
分三种情况。
情况1:无鉴权(最简单)
请求类似:
get https://api.xxx.com/gold
直接:
import requests

url = "https://api.xxx.com/gold"
res = requests.get(url).json()

print(res)
完成。
情况2:需要 headers
例如:
user-agent
referer
cookie
复制浏览器请求头:
headers = {
 "user-agent": "...",
 "referer": "...",
 "cookie": "..."
}


requests.get(url, headers=headers)
情况3:接口有加密
当接口存在:
例如:
sign=md5(timestamp+secret)
需要:
逆向 js 算法。
使用:
让爬虫 执行 javascript。
除了 ajax,还有一种传统爬虫无法直接抓取数据的情况,就是使用了 websocket 协议传输数据。
websocket 是一种基于 tcp 的全双工双向通信协议,和我们熟悉的 http 有本质区别:
websocket 连接建立时,必须先通过 http 协议进行握手(http upgrade)。客户端发送一个 http 请求,请求升级协议。
示例:
get /chat http/1.1
host: server.example.com
upgrade: websocket
connection: upgrade
sec-websocket-key: xxxxx
sec-websocket-version: 13
服务器如果同意升级,会返回:
http/1.1 101 switching protocols
upgrade: websocket
connection: upgrade
然后:
http 连接升级为 websocket
后续通信就 不再使用 http,而是 websocket 帧协议
因此可以总结为:
websocket = http 握手 + 独立通信协议
端口和网络兼容
websocket 通常使用:
| 协议 | 默认端口 |
|---|---|
| http | 80 |
| https | 443 |
| ws | 80 |
| wss | 443 |
常见使用 ws 的典型场景:
特点:数据不是一次性加载,而是持续推送。页面初始 html 可能完全没数据(或只有骨架),所有内容靠 ws 实时进来。
1、f12 → network
2、看 initiator:很多是 main.js 或 socket.js 发起的持久连接
推荐优先级(从易到难):
pythonfrom playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(headless=false)
    page = browser.new_page()
    page.goto("目标网址")

    # 监听所有 websocket
    page.on("websocket", lambda ws: print("ws 连接:", ws.url))

    # 监听消息(核心!)
    def handle_message(msg):
        print("收到 ws 数据:", msg)   # 这里就是你要的数据

    page.on("websocket", lambda ws: ws.on("framereceived", handle_message))

    input("按回车结束...")  # 保持运行
优点:自动处理握手、cookie、反爬,几乎零逆向。
pythonimport websocket

def on_message(ws, message):
    print("实时数据:", message)   # 解析 json 即可

ws = websocket.websocketapp(
    "wss://xxx.com/socket",          # 从 network 复制 ws 地址
    on_message=on_message,
    header={"cookie": "你的cookie"}   # 带登录态
)
ws.run_forever()
部分网站 ws 连接参数加密(token、sign、device_id),需要先逆向 js 才能构造 ws url。这时通常结合 playwright 更稳。
到此这篇关于前端ajax+动态页面爬虫实战思路的文章就介绍到这了,更多相关前端ajax动态页面爬虫内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!
您想发表意见!!点此发布评论
版权声明:本文内容由互联网用户贡献,该文观点仅代表作者本人。本站仅提供信息存储服务,不拥有所有权,不承担相关法律责任。 如发现本站有涉嫌抄袭侵权/违法违规的内容, 请发送邮件至 2386932994@qq.com 举报,一经查实将立刻删除。


发表评论