
JVM垃圾回收机制详解:方法区与堆的回收算法有哪些
72人参与 • 2026-08-28 • 算法
1. 方法区的回收
方法区中能够回收的内容主要是不再使用的类。我们知道类的生命周期有七个部分,最后一个就是卸载。
判定一个类可以被卸载,需要同时满足三个条件:
1、此类的所有实例对象都已经被回收了,也就是说在堆中已经不存在该类的实例对象以及子类对象了。
class<?> clazz = loader.loadclass("com.zhj.a");
object o = clazz.newinstance();
o = null;
2、加载该类的类加载器已经被回收了。
urlclassloader loader = new urlclassloader(new url[]{new url("file:d:\\lib\\")});
loader = null;
3、该类对应的 java.lang.class 对象没有在任何地方被引用。
class<?> clazz = loader.loadclass("com.zhj.a");
clazz = null;
我们知道,项目当中我们自己创建的类都是由应用程序类加载器来进行加载的,而应用程序类加载器是不会被置为null的,也就是说这个类无法被卸载。
但是在一些特定场景下还是会出现类加载器被置为null的情况,主要在如 osgi、jsp 的热部署等应用场景中。 每个jsp文件对应一个唯一的类加载器,当一个jsp文件修改了,就直接卸载这个jsp类 加载器。重新创建类加载器,重新加载jsp文件。
2. 堆的回收
2.1 引用计数法
引用计数法:java中的对象是否能被回收,是根据对象是否被引用来决定的。如果对象被引用了,说明该对象还在使用,不允许被回收。引用计数法会为每个对象维护一个引用计数器,当对象被引用时加1,取消引用时减1。
优点:
- 实现简单。
缺点:
- 每次引用和取消引用都需要维护计数器,对系统性能会有一定的影响。
- 存在循环引用,a,b对象相互引用时会出现对象无法回收的问题,造成内存泄漏。
2.2 可达性分析算法
可达性分析算法:java使用的是可达性分析算法来判断对象是否可以被回收。可达性分析将对象分为两类:垃圾回收的根对象(gc root)和普通对象,对象与对象之间存在引用关系。
a到b再到c和d,形成了一个引用链,可达性分析算法指的是如果从某个到gc root对象是可达的,对象就不可被回收。
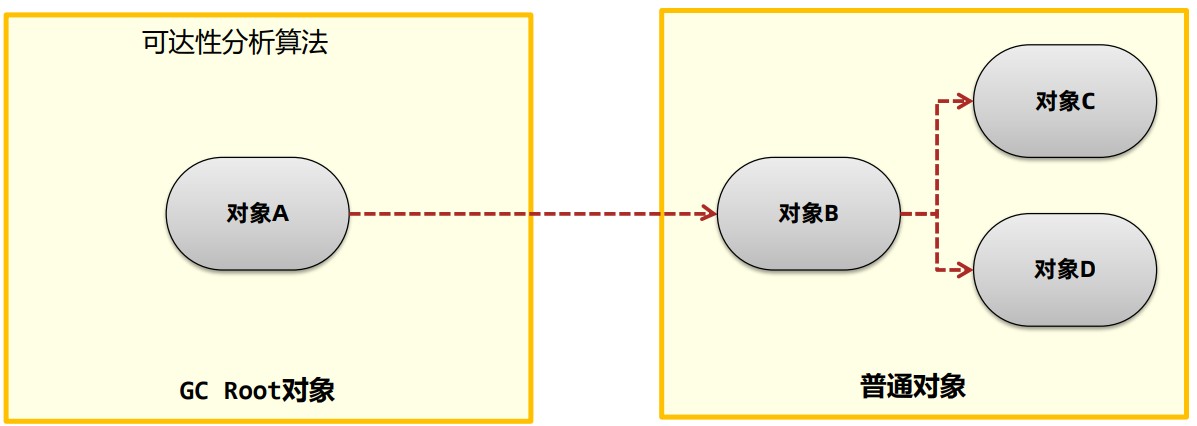
也就是说,如果对象a到对象b的引用链断了,那么对象b,c,d都可以被垃圾回收了。
那么哪些对象可以被称之为gc root呢?
- 虚拟机栈(栈帧中的本地变量表)中引用的对象
- 本地方法栈(native方法)中引用的对象
- 方法区中类静态属性引用的对象
- 方法区中常量引用的对象
- 所有被同步锁持有的对象
main线程作为虚拟机栈中引用的对象可以作为gc root,那么可以通过它去判断对象是否可以回收:
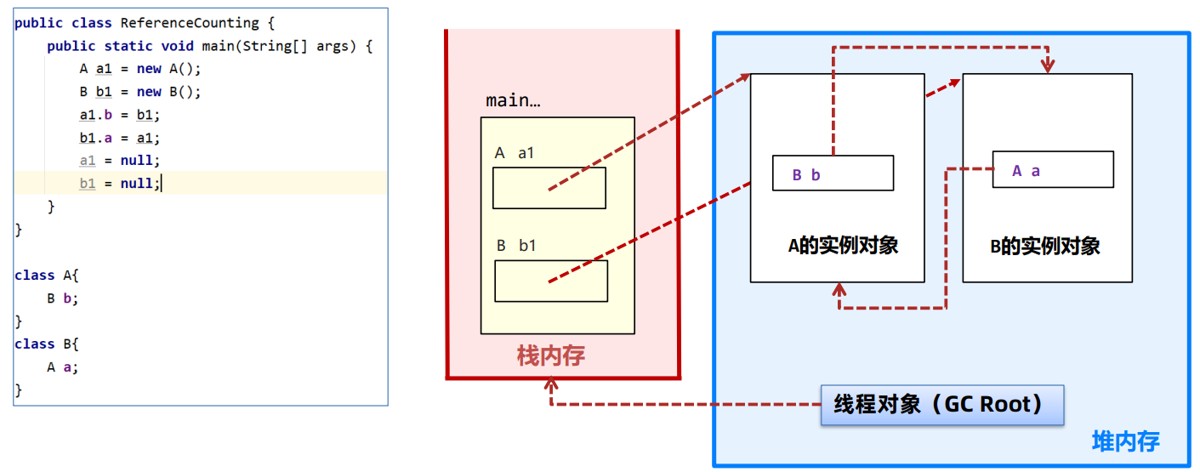
当 a1 b1 置为 null 时,也就表示栈内存中 a1 到堆内存中 a的实例对象的引用链断了,b1 到堆内存中 b的实例对象的引用链断了,所以线程对象根据引用链到不了ab的实例对象了,所以ab的实例对象就可以被垃圾回收了。
3. 对象引用
3.1 强引用
可达性分析算法中描述的对象引用,一般指的是强引用,即是gcroot对象对普通对象有引用关系,只要这层关系存在,普通对象就不会被回收。
3.2 软引用
软引用相对于强引用是一种比较弱的引用关系,如果一个对象只有软引用关联到它,当程序内存不足时,就会将软 引用中的数据进行回收。
在jdk 1.2版之后提供了softreference类来实现软引用,软引用常用于缓存中。
软引用的执行过程如下:
将对象使用软引用包装起来。
byte[] bytes = new byte[1024 * 1024 * 100];
//将100m的数据放入软引用中
softreference<byte[]> softreference = new softreference<byte[]>(bytes);
内存不足时,虚拟机尝试垃圾回收。
如果垃圾回收仍不能解决内存不足的问题,则回收软引用中的对象。
如果内存依旧不足,则抛出oom异常。
软引用中的对象如果在内存不足时回收,softreference对象本身也需要被回收,我们又如何在适当时机将它回收呢?
softreference提供了一套队列机制:
- 软引用创建时,通过构造器传入引用队列。
- 在软引用中包含的对象被回收时,将该softreference对象本身放入引用队列。
- 通过代码遍历引用队列,将softreference的强引用删除。
3.3 弱引用
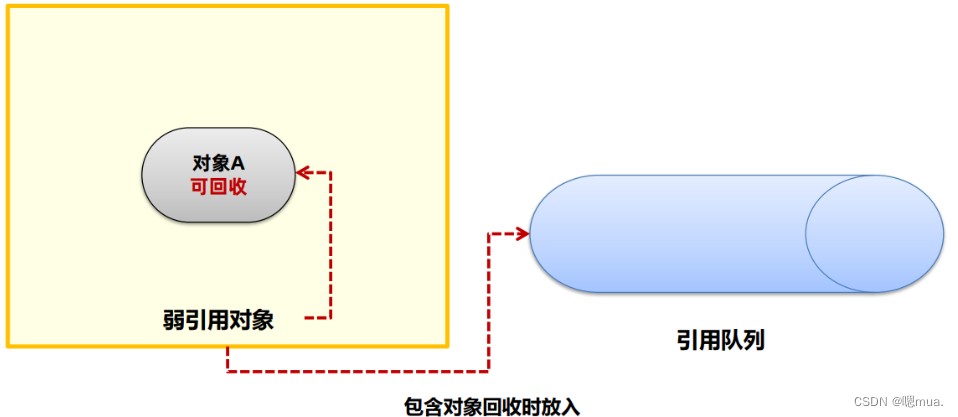
弱引用的整体机制和软引用基本一致,区别在于弱引用包含的对象在垃圾回收时,不管内存够不够都会直接被回收。
在jdk 1.2版之后提供了weakreference类来实现弱引用,弱引用主要在threadlocal中使用。 弱引用对象本身也可以使用引用队列进行回收。
3.4 虚引用和终结器引用
这两种引用在常规开发中是不会使用的。
- 虚引用也叫幽灵引用/幻影引用,不能通过虚引用对象获取到包含的对象。虚引用唯一的用途是当对象被垃圾回收器回收时可以接收到对应的通知。java中使用phantomreference实现了虚引用,直接内存中为了及时知道 直接内存对象不再使用,从而回收内存,使用了虚引用来实现。
- 终结器引用指的是在对象需要被回收时,终结器引用会关联对象并放置在finalizer类中的引用队列中,在稍后由一条由finalizerthread线程从队列中获取对象,然后执行对象的finalize方法,在对象第二次被回收时,该 对象才真正的被回收。在这个过程中可以在finalize方法中再将自身对象使用强引用关联上,但是不建议这样做。
4. 垃圾回收算法
垃圾回收要做的两件事:
- 找到内存中存活的对象
- 释放不再存活的对象的内存,使得程序能再次利用这部分空间。
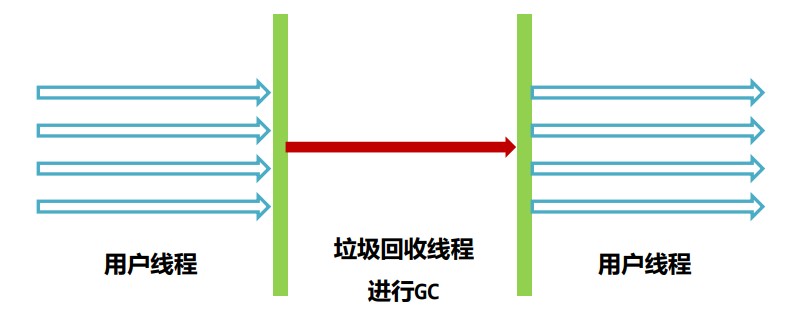
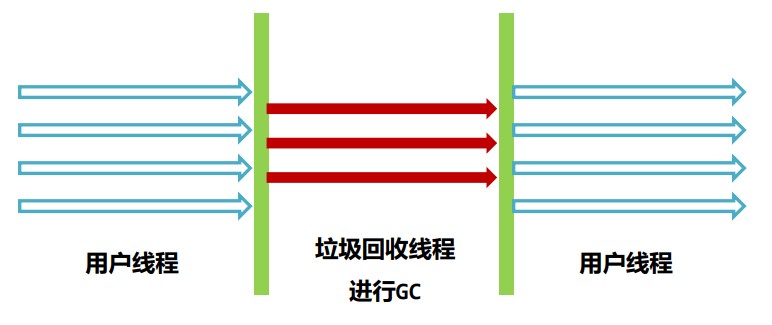
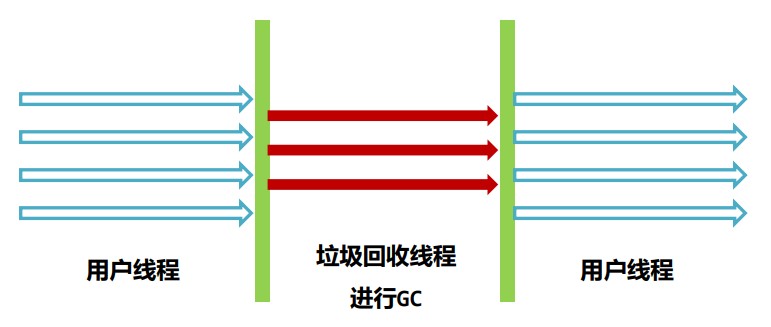
java垃圾回收过程通过单独的gc线程来完成,不管使用哪一种gc算法,都会有部分阶段需要停止所有的用户线程。这个过程被称之为 stop the world 简称stw,如果stw时间过长则会影响用户的使用。
垃圾回收算法的评价标准
判断垃圾回收算法是否优秀,可从以下三个方面来考虑:
吞吐量:吞吐量指的是 cpu 用于执行用户代码的时间与 cpu 总执行时间的比值,即吞吐量 = 执行用户代码时间 / (执行用户代码时间 + gc时间)。吞吐量数值越高,垃圾回收的效率就越高。
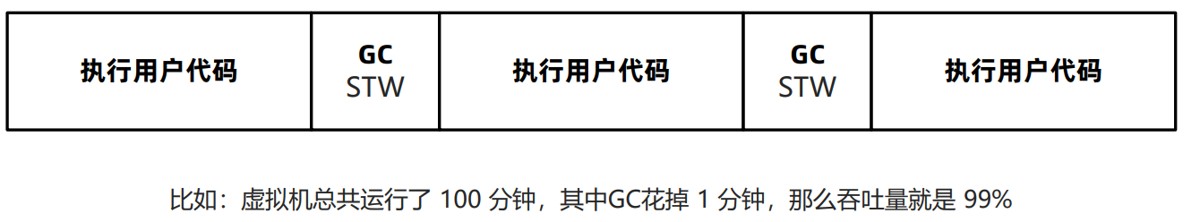
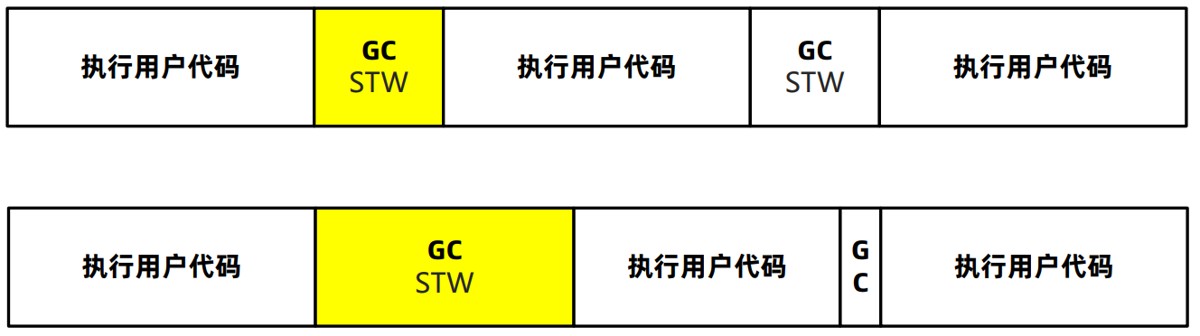
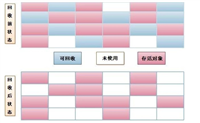
最大暂停时间:最大暂停时间指的是所有在垃圾回收过程中的stw时间最大值。比如如下的图中,黄色部分的stw就是最 大暂停时间,显而易见上面的图比下面的图拥有更少的最大暂停时间。最大暂停时间越短,用户使用系统时受到的影响就越短。
堆使用率:不同垃圾回收算法,对堆内存的使用方式是不同的。比如标记清除算法,可以使用完整的堆内存。而复制算 法会将堆内存一分为二,每次只能使用一半内存。从堆使用效率上来说,标记清除算法要优于复制算法。
上面提到的三种评价标准:吞吐量,最大暂停时间,堆使用率不可兼得。
一般来说,堆内存越大,最大暂停时间就越长,想要减少最大暂停时间,就会降低吞吐量。所以说没有最好的算法,只有最适合不同场景的算法。
4.1 标记清除算法
标记清除算法的核心思想分为两个阶段:
- 标记阶段:使用可达性分析算法从gc root通过引用链标记所有存活对象。
- 清除阶段:从内存中删除没有被标记的对象。
优点:
实现简单,只需在标记阶段给每个对象维护标志位,在清除阶段删除对象即可。
缺点:
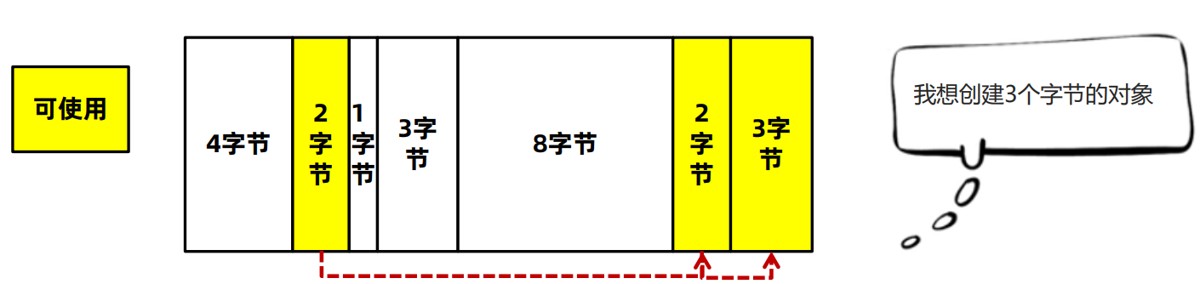
- 造成内存碎片。由于内存是连续的,所以在对象被删除之后,内存中会出现很多细小的可用内存单元。如果我们需要的是一 个比较大的空间,很有可能这些内存单元的大小过小无法进行分配。
- 分配速度慢。由于内存碎片的存在, 需要维护一个空闲链表,极有可能发生每次需要遍历到链表的最后才能获得合适的内存空间。
4.2 复制算法
复制算法的核心思想是:
- 准备两块空间from空间和to空间,每次在对象分配阶段,只使用from空间。
- 在垃圾回收阶段,将from中存活对象复制到to空间。
- 将两块空间名字互换。
优点:
- 吞吐量高
- 不会发生内存碎片,复制算法在复制之后就会将对象按顺序放 入to空间中,所以对象以外的区域都是可 用空间,不存在碎片化内存空间。
缺点:
- 内存使用率低,每次只能让一半的内存空间给创建对象使用。
4.3 标记整理算法
标记整理算法核心思想分为两个阶段:
- 标记阶段:使用可达性分析算法从gc root通过引用链标记所有存活对象。
- 整理阶段:将存活对象移动到堆的一端,从内存中删除没有存活的对象。
优点:
- 内存使用率高:整个堆内存都可以使用,不会像复 制算法只能使用半个堆内存
- 不会发生碎片化:在整理阶段可以将对象往内存的一侧进行移动,剩下的空间都是可以分配对象的有效空间
- 整理阶段的效率不高
4.4 分代垃圾回收算法
现代优秀的垃圾回收算法,会将上述描述的算法组合使用,其中应用最广的就是分代垃圾回收算法。
分代垃圾回收将整个内存区域划分为年轻代和老年代。年轻代用来存放存活时间较短的对象,老年代用来存放存活时间较长的对象。
年轻代由有三部分组成:
- eden区/伊甸园区
- s0幸存区
- s1幸存区
调整内存区域大小
根据以下虚拟机参数,调整堆的大小并观察结果。注意加上 -xx:+useserialgc
分代垃圾回收流程:
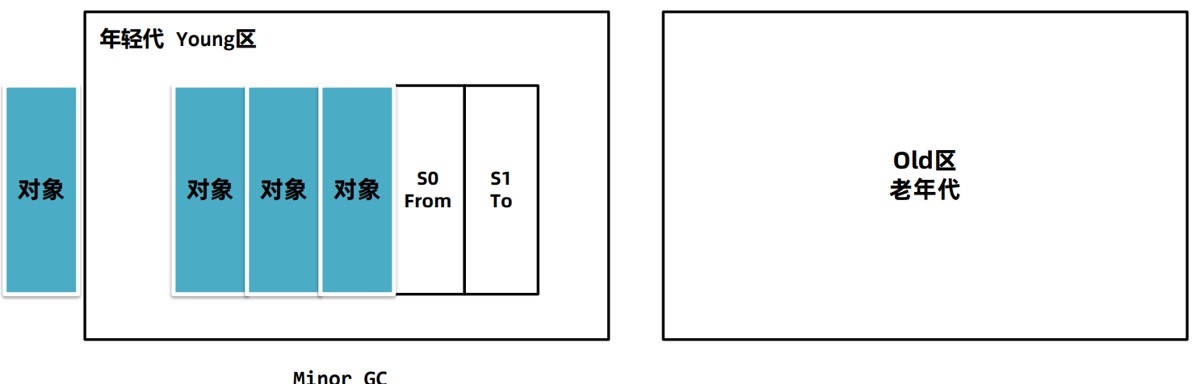
分代回收时,创建出来的对象首先被放入eden伊甸园区。
随着对象在eden区越来越多,如果eden区满了,新创建的对象无法放入,就会触发年轻代的gc,称之为minor gc或者young gc。minor gc会把需要eden中区中和from需要回收的对象回收,把没有回收的对象放入to区。
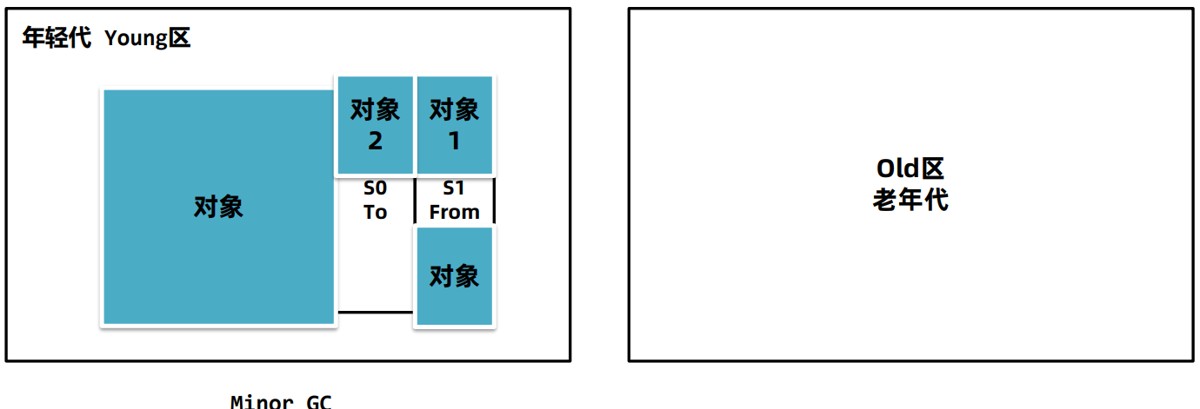
接下来,s0会变成to区,s1变成from区。当eden区满时再往里放入对象,依然会发生minor gc。此时回收eden区和s1(from)中的对象,并把eden和from区中剩余对象放入s0(to)。(注意:每次 minor gc都会为对象记录他的年龄,初始值为0,每次gc完加1)
如果minor gc后对象的年龄达到阈值(最大15,默认值和垃圾回收器有关),对象就会被晋升至老年代。
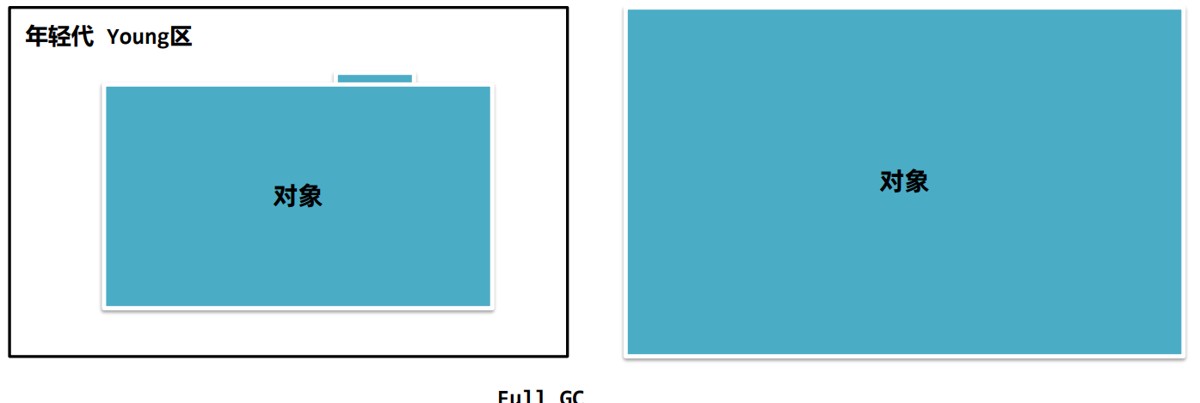
当老年代中空间不足导致无法放入新对象时,会先尝试minor gc(因为不是只有年龄到达15的对象会放入老年代,如果新生代中存放了很多年龄不大的兑现导致新生代中满了,年轻对象也会放入老年代),如果还是不足,就会触发full gc,full gc会对整个堆进行垃圾回收。如果full gc依然无法回收掉老年代的对象,那么当对象继续放入老年代时就会抛出oom异常。
5. 垃圾回收器
- 系统中的大部分对象,都是创建出来之后很快就不再使用可以被回收的,比如用户获取订单数据,订单数据返回给用户之后就可以释放了。
- 老年代中会存放长期存活的对象,比如spring的大部分bean对象,在程序启动之后就不会被回收了。
- 在虚拟机的默认设置中,新生代大小要远小于老年代的大小。
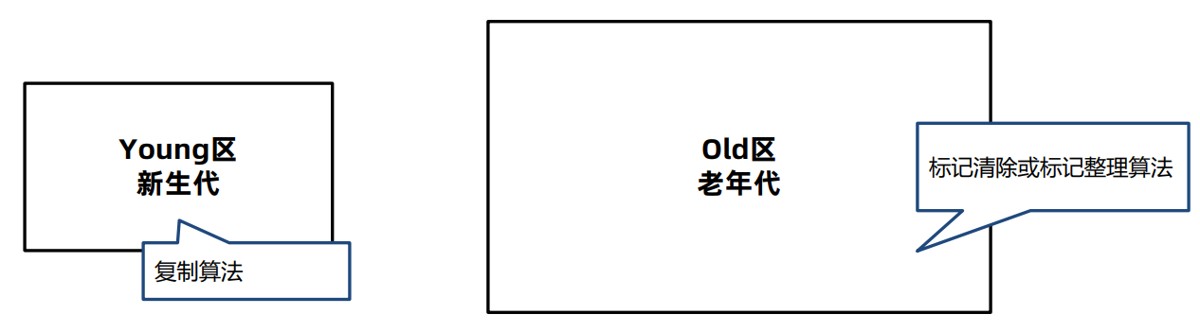
分代gc算法将堆分成年轻代和老年代的主要原因有:
- 可以通过调整年轻代和老年代的比例来适应不同类型的应用程序,提高内存的利用率和性能。
- 新生代和老年代使用不同的垃圾回收算法,新生代一般选择复制算法,老年代可以选择标记清除和标记整理算法,由程序员来选择灵活度较高。
- 分代的设计中允许只回收新生代(minor gc),如果能满足对象分配的要求就不需要对整个堆进行回收(full gc),stw时间就会减少。
垃圾回收器是垃圾回收算法的具体实现。
由于垃圾回收器分为年轻代和老年代,除了g1之外其他垃圾回收器必须成对组合使用。
5.1 年轻代-serial垃圾回收器
serial是一种单线程串行回收年轻代的垃圾回收器。使用复制算法。
- 优点:单cpu处理器下吞吐量非常出色。
- 缺点:多cpu下吞吐量不如其他垃圾回收器,堆如果偏大会让用户线程处于长时间的等待。
- 适用场景:java编写的客户端程序或者硬件配置有限的场景。
5.2 老年代-serialold垃圾回收器
serialold是serial垃圾回收器的老年代版本,采用单线程串行垃圾回收,使用标记整理算法。使用 -xx:+useserialgc 指令则年轻代和老年代都使用串行回收器。
- 优点:单cpu处理器下吞吐量非常出色
- 缺点:多cpu下吞吐量不如其他垃圾回收器,堆如果偏大会让用户线程处于长时间的等待
- 适用场景:与serial垃圾回收器搭配使用, 或者在cms特殊情况下使用
5.3 年轻代-parnew垃圾回收器
parnew垃圾回收器本质上是对serial在多cpu下的优化,使用多线程进行垃圾回收,使用复制算法。 -xx:+useparnewgc 年轻代使用parnew垃圾回收器,老年代使用serialold垃圾回收器。
- 优点:多cpu处理器下停顿时间较短
- 缺点:吞吐量和停顿时间不如g1,所以在jdk9后不建议使用
- 适用场景:jdk8及之前的版本中,与cms老年代垃圾回收器搭配使用。
5.4 老年代-cms(concurrent mark sweep)垃圾回收器
cms垃圾回收器关注的是系统的暂停时间,允许用户线程和垃圾回收线程在某些步骤中同时执行,减少了用户线程的等待时间。使用标记清除算法。 -xx:+useconcmarksweepgc
优点:系统由于垃圾回收出现的停顿时间较短,用户体验好。
缺点:
- 内存碎片问题。
- 退化问题。
- 浮动垃圾问题。
适用场景:大型的互联网系统中用户请求数 据量大、频率高的场景 比如订单接口、商品接口等。
cms的执行步骤:
- 初始标记,用极短的时间标记出gc root能直接关联到的对象。
- 并发标记。标记所有对象,用户线程不需要暂停。
- 重新标记,由于并发标记阶段有些对象会发生变化,存在错标,漏标等情况,需要重新标记。
- 并发清理,清理死亡的对象,用户线程不需要暂停。
cms的缺点:
- cms使用了标记清除算法,在垃圾回收结束之后会出现大量的内存碎片,cms会在full gc时进行碎片的整理。这样会导致用户线程暂停,可以使用
-xx:cmsfullgcsbeforecompaction=n参数调整n(默认为0)次full gc之后再整理。 - 无法处理在并发清理过程中产生的”浮动垃圾“(在并发清理阶段用户线程产生的垃圾不能立即回收,需要等到下次并发清理),不能做到完全的垃圾回收。
- 如果老年代内存不足无法分配对象,cms就会退化成serial old单线程回收老年代。
5.5 年轻代-parallel scavenge垃圾回收器
parallel scavenge垃圾回收器是jdk8默认的年轻代垃圾回收器,多线程并行回收,关注的是系统的吞吐量。具备自动调整堆内存大小的特点。使用复制算法。
- 优点:吞吐量高,而且手动可控。 为了提高吞吐量,虚拟机会动态调整堆的参数。
- 缺点:不能保证单次的停顿时间。
- 适用场景:后台任务,不需要与用户交互,并且容易产生大量的对象 比如:大数据的处理,大文件导出
5.6 老年代-parallel old垃圾回收器
parallel old是为parallel scavenge收集器设计的老年代版本,利用多线程并发收集。适用标记整理算法。
参数:-xx:+useparallelgc 或者 -xx:+useparalleloldgc 可以使用parallel scavenge + parallel old这种组合。
- **优点:**并发收集,在多核cpu下 效率较高
- 缺点:暂停时间会比较长
- 适用场景:与parallel scavenge配套使用
parallel scavenge允许手动设置最大暂停时间和吞吐量。oracle官方建议在使用这个组合时,不要设置堆内存的最大值,垃圾回收器会根据最大暂停时间和吞吐量 自动调整内存大小。
- 最大暂停时间:
-xx:maxgcpausemillis=n设置每次垃圾回收时的最大停顿毫秒数 - 吞吐量:
-xx:gctimeratio=n设置吞吐量为n(用户线程执行时间 = n/n + 1) - 自动调整内存大小:
-xx:+useadaptivesizepolicy设置 可以让垃圾回收器根据吞吐量和最大停顿的毫秒数自动调整内存大小
5.7 g1垃圾回收器
参数1: -xx:+useg1gc 打开g1的开关,jdk9之后默认不需要打开。
参数2:-xx:maxgcpausemillis=毫秒值 最大暂停的时间。使用复制算法。
- 优点:对比较大的堆如超过6g的堆回收时,延迟可控,不会产生内存碎片,并发标记的satb算法效率高
- 缺点:jdk8之前还不够成熟
- 适用场景:jdk8最新版本,jdk9之后建议默认适用。
jdk9之后默认的垃圾回收器是g1(garbage first)垃圾回收器。
parallel scavenge关注吞吐量,允许用户设置最大暂停时间,但是会减少年轻代可用空间的大小。
cms关注暂停时间,但是吞吐量方面会下降。
而g1设计目标就是将上述两种垃圾回收器的优点融合(jdk9之后建议使用g1垃圾回收器):
- 支持巨大的堆空间回收,并有较高的吞吐量。
- 支持多cpu并行垃圾回收。
- 允许用户设置最大暂停时间。
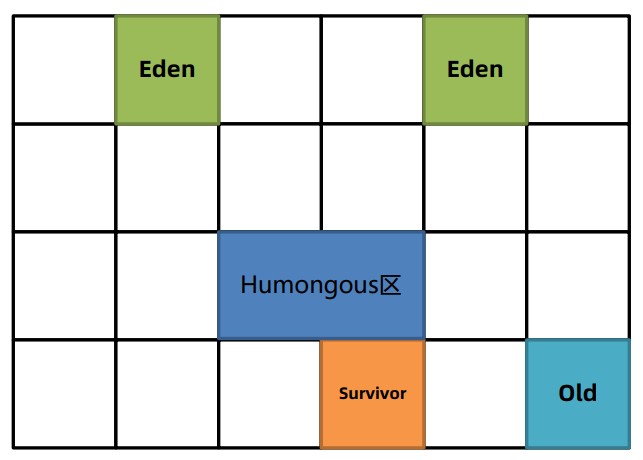
在g1出现之前的垃圾回收器,内存结构一般是连续的,如下图所示:
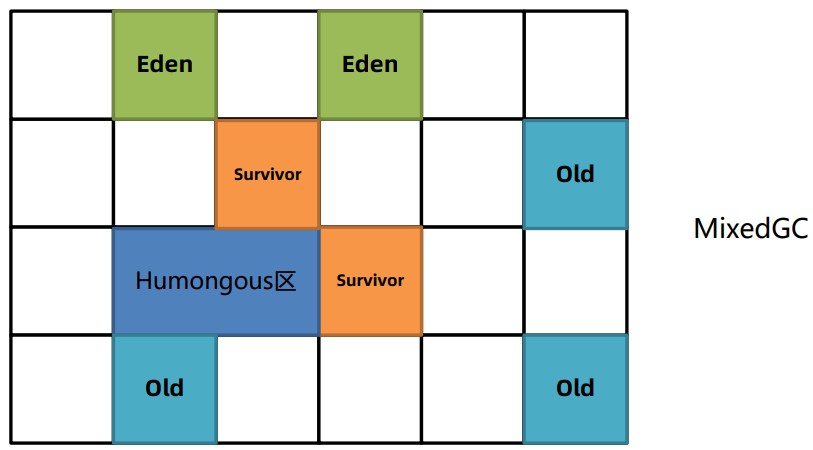
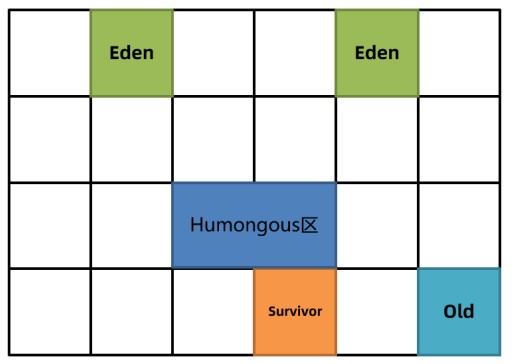
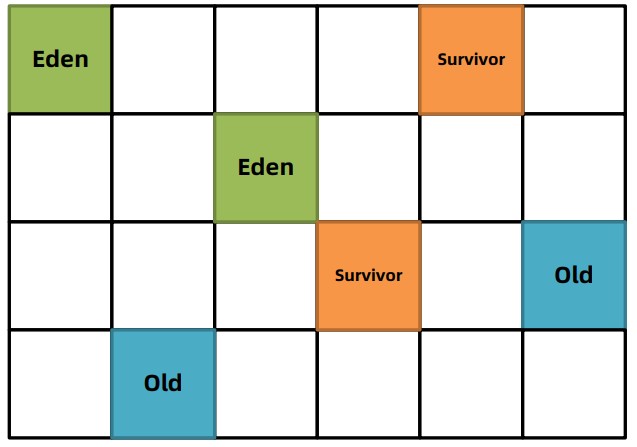
而在g1中整个堆会被划分成多个大小相等的区域,称之为区region,区域不要求是连续的。
分为eden、survivor、 old区。region的大小通过堆空间大小/2048计算得到,也可以通过参数 -xx:g1heapregionsize=32m 指定(其中32m指定region大小为32m),region size必须是2的指数幂,取值范围从1m到32m。
g1垃圾回收有两种方式:
- 年轻代回收(young gc)
- 混合回收(mixed gc)
年轻代回收(young gc),回收eden和survivor区中不用的对象。会导致stw,g1中可以通过参数 -xx:maxgcpausemillis=n (默认为200)设置每次垃圾回收时的最大暂停时间毫秒数,g1垃圾回收器会尽可能的保证暂停时间。
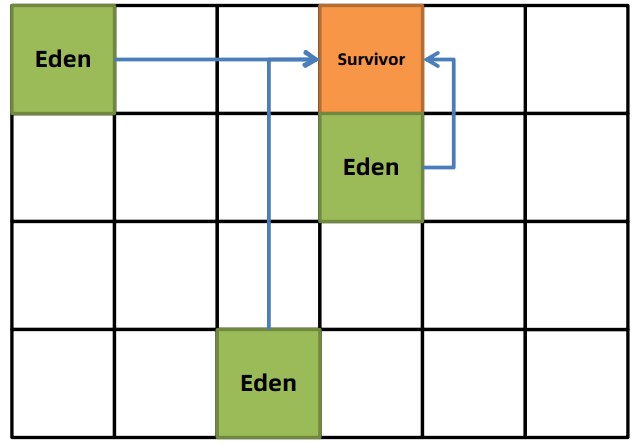
年轻代回收执行流程:
- 新创建的对象会存放在eden区。当g1判断年轻代区不足(max默认60%),无法分配对象时需要回收时会执行 young gc。
- 标记出eden和survivor区域中的存活对象
- 根据配置的最大暂停时间选择某些区域将存活对象复制到一个新的survivor区中(年龄+1),清空这些区域。
g1在进行young gc的过程中会去记录每次垃圾回收时每个eden区和survivor区的平均耗时,以作为下次回收时的参考依据。这样就可以根据配置的最大暂停时间计算出本次回收时最多能回收多少个region区域了。
比如 -xx:maxgcpausemillis=n(默认200),每个region回收耗时40ms,那么这次回收最多只能回收4个region。
- 后续young gc时与之前相同,只不过survivor区中存活对象会被搬运到另一个suvivor区。
- 当某个存活对象的年龄到达阈值(默认15),将被放入老年代。
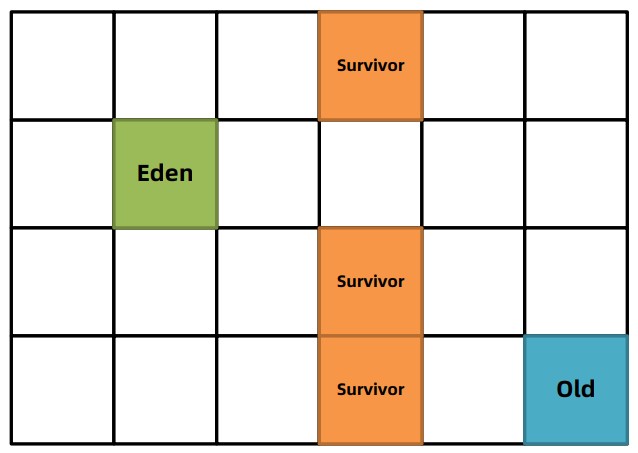
- 部分对象如果大小超过region的一半,会直接放入老年代,这类老年代被称为
humongous区。比如堆内存是4g,每个region是2m,只要一个大对象超过了1m就被放入humongous区,如果对象过大会横跨多个region。
- 多次回收之后,会出现很多old老年代区,此时总堆占有率达到阈值时(
-xx:initiatingheapoccupancypercent默认45%)会触发混合回收mixedgc,回收所有年轻代和部分老年代的对象以及大对象区。采用复制算法来完成。
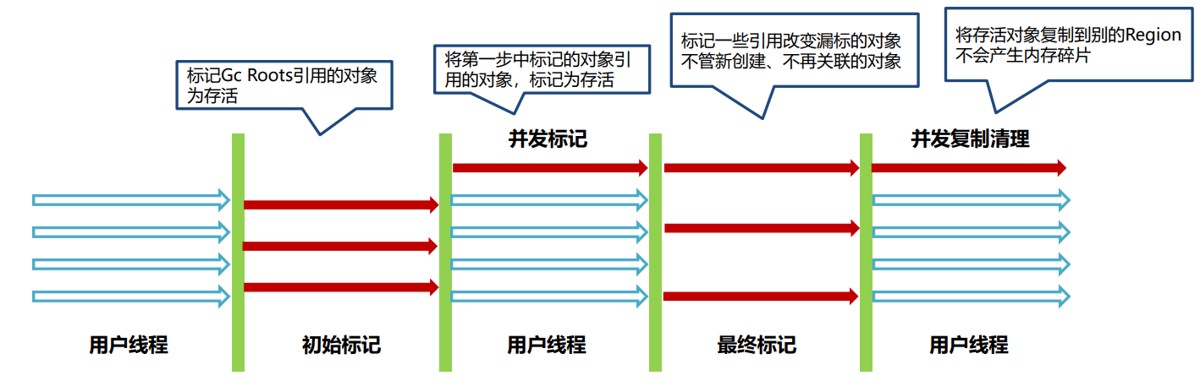
**混合回收(mixed gc)**分为:初始标记(initial mark),并发标记(concurrent mark),最终标记(remark或者finalize marking),并发清理(cleanup)。
g1对老年代的清理会选择存活度最低的区域来进行回收,这样可以保证回收效率最高,这也是g1(garbage first)名称的由来。
最后清理阶段使用复制算法,不会产生内存碎片。
注意:
如果清理过程中发现没有足够的空region存放转移的对象,会出现full gc。单线程执行标记-整理算法, 此时会导致用户线程的暂停。所以尽量保证应该用的堆内存有一定多余的空间。
总结
jdk8及之前:
- parnew + cms (关注暂停时间)
- ps + po(关注吞吐量)
- g1(jdk8之前不建议,较大堆并且关注暂停时间)
jdk9之后:
- g1(默认)
以上为个人经验,希望能给大家一个参考,也希望大家多多支持代码网。
赞 (0)
您想发表意见!!点此发布评论

发表评论