
Redis事务机制详解
47人参与 • 2026-09-04 • Redis
事务的概念
说到事务,最经典的例子就是mysql中的转账操作:a给b转账500元,需要先把a的余额减500,再把b的余额加500。这两个操作必须打包成一个整体,要么全都执行,要么一个都不执行,绝不能只执行一半——否则钱就凭空消失了。
mysql的事务有四个核心特性,也就是常说的acid:
- 原子性(atomicity):把多个操作打包成一个整体,要么全部成功,要么全部失败。
- 一致性(consistency):事务执行前和执行后,数据都需要和预期保持一致。
- 持久性(durability):事务中做出的修改都会存储到硬盘上。
- 隔离性(isolation):多个事务并发执行时会引发一系列问题,通过隔离级别来控制。
注:隔离性属于事务的一种性质(或者说管理机制),mysql还借助mvcc等机制来实现更高效的并发控制。
redis也支持事务,但和mysql相比更像是一个"半成品",实现得相当简单。下面就逐条对照acid来看看redis的事务到底"缺"了什么。
一、redis事务的特性
1.1 原子性
redis的事务是否具备原子性,这件事其实是存在争议的。
原子性原本的含义是"把多个操作打包在一起,要么全执行,要么全不执行"。而mysql把这个门槛提高了:mysql的事务要么执行成功,要么全部不执行,一旦中途失败还能通过回滚恢复到事务开始前的状态。
redis则不保证这一点,事务中的某个命令执行失败了,就是失败了,前面已经执行成功的命令并不会被撤销,也没有任何回滚机制。
正因为大家一提到原子性就习惯性地对标mysql,所以就出现了两种声音:有人认为redis有原子性(它确实做到了"打包执行"),有人认为没有(它做不到"失败回滚")。
有意思的是,redis旧版本的官方文档里明确写着事务具有原子性,而新版本的文档中这句话又被去掉了。😄
1.2 一致性
redis没有像mysql那样的约束(主键约束、外键约束、非空约束等),也没有回滚机制,事务失败了就是失败了,因此完全有可能出现数据不一致的情况。
1.3 持久性
redis虽然支持持久化机制(rdb和aof),但那是redis整体的能力,和事务本身没有关系。事务并不保证自己所做的修改一定落到了硬盘上,所以从事务的角度讲,redis是不具备持久性的。
1.4 隔离性
这一条redis压根就不涉及。redis是单线程处理请求的程序,所有命令都是串行执行的,天然不存在多个事务并发交叉执行的问题,自然也就不需要隔离级别这套东西。
可以看出,acid四条里redis基本只沾了原子性的一点边。那redis的事务到底还有什么用呢?
二、事务的意义与实现原理
redis事务的核心意义只有一个:把一个业务需要的多个命令打包在一起执行,避免其他客户端的命令插队到中间。
它的实现方式也很朴素——引入了一个队列(每个客户端各有一个,且只有在开启事务时才会分配)。开启事务之后,客户端发送的命令并不会立即执行,而是先进入这个队列排队;直到遇到"执行事务"这个命令时,才把队列中的所有任务按顺序依次执行完。
那redis的事务为什么做得这么简单,不设计成mysql那样强大呢?
因为mysql事务的强大是付出了代价的:空间上要额外维护回滚日志、版本链等结构,时间上也有更大的开销。正是mysql存在这些"重"的问题,才给了redis这种轻量方案上场的机会。用不用得上,取决于业务对可靠性和性能的取舍。
三、事务的操作命令
3.1 multi、exec、discard
multi
功能:开启一个事务。
语法:
multi
执行之后,当前客户端就进入了事务状态,后续的命令都会被放进队列而不是立即执行。
exec
功能:执行事务,把队列中排队的命令按顺序全部执行掉。
语法:
exec
返回值:一个数组,依次对应队列中每个命令的执行结果。
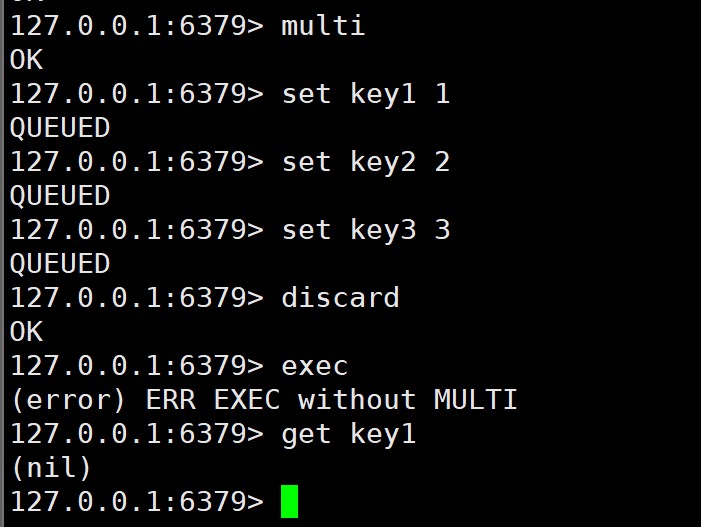
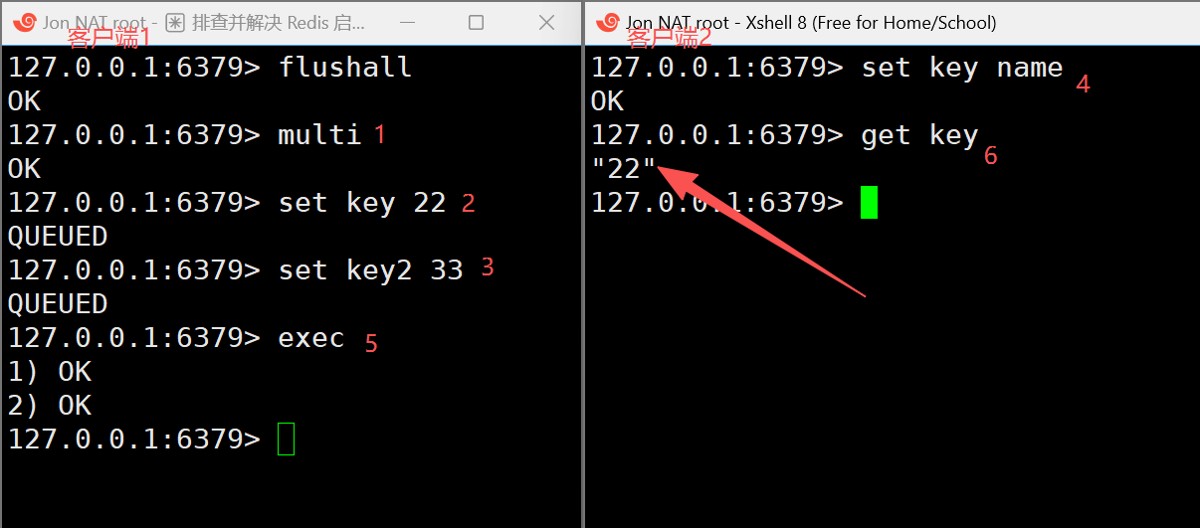
可以看下面的效果:在multi之后输入的命令,返回的都是queued,说明它们只是被保存到队列里了,并没有真正执行。此时另开一个客户端去查询,也确实查不到这些数据,只有exec之后才会真正生效。
discard
功能:丢弃事务,把队列中攒下的命令全部清空,一个都不执行。
语法:
discard
验证discard的效果:
那么如果开启事务并且给服务器发了若干命令之后,服务器重启了会怎么样?因为队列是保存在内存中的,重启之后这些排队的命令自然全都没了,效果就等价于执行了一次discard。
3.2 watch与unwatch
前面提到,事务中的命令是在exec的时候才真正执行的,也就是说命令的实际执行时机被推后了。这就容易产生歧义:在multi到exec这段时间里,如果有其他客户端把我关心的key改掉了,我这个事务再执行下去可能就不符合预期了。
为了解决这个问题,redis提供了watch。
watch
功能:监控一个或多个key,观察它们在事务执行前是否被改动过。
语法:
watch <key> [key ......]
它的作用是:检查这些key在multi和exec之间是否被外部(其他客户端)修改过。如果被修改了,那么exec时整个事务就不会真正执行,直接返回nil。
使用watch:
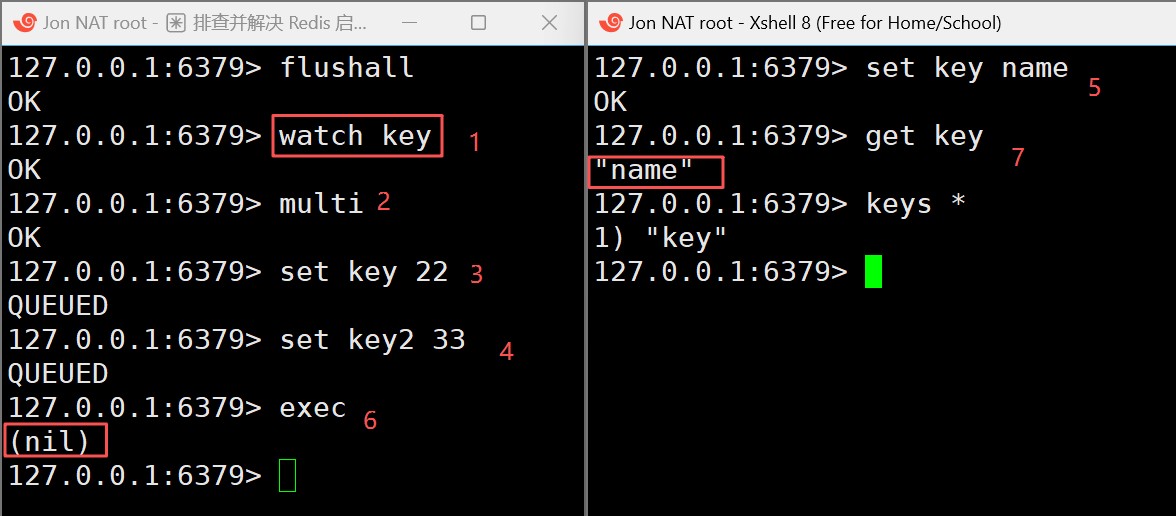
注意:watch必须搭配事务使用,并且必须在multi之前执行,否则是没有意义的。
unwatch
功能:取消对所有key的监控,是watch的反向操作。
语法:
unwatch
用法和watch类似,这里不再赘述。
3.3 watch的实现原理
watch本质上是一个乐观锁。
需要说明的是,乐观锁和悲观锁并不是指某种具体的锁,而是指锁的一种特性或者说思路:
- 乐观锁:预期锁冲突的概率很低,所以先不加锁,等真正要提交的时候再检查有没有冲突。
- 悲观锁:预期锁冲突的概率很高,所以干脆一上来就把资源锁住,不让别人碰。
redis的具体做法是给被watch的key分配一个版本号,每次这个key被修改,版本号都会变大。等到执行事务时,再判断当前key的版本号和最初watch时记录下来的版本号是否一致:一致就说明期间没有其他客户端修改过,事务正常执行;不一致就说明数据已经变了,事务直接放弃。
这个思路和cas(compare and swap)中通过版本号解决aba问题的做法是非常类似的。
四、应用场景
那么什么时候会需要用到redis的事务呢?最典型的就是秒杀这类场景。
假设要卖一批限量商品,一个很自然的写法是:
//获取仓库中的商品个数
int count = redis 执行命令:get goods:count;
if (count > 0)
{
    //下单成功
    下单();
    //商品数量减一
    redis 执行命令:decr goods:count;
} 这段代码存在明显的线程安全问题:假如库存只剩1件,两个客户端几乎同时读到count = 1,于是都判断为可以下单,最后都执行了decr,库存变成了-1,也就是出现了超卖。
问题的根源在于"判断"和"扣减"这两个操作不是原子的,中间被其他请求插队了。在多线程编程中我们会用加锁来避免这种插队,而在redis中,用事务就能达到同样的效果。
把这组命令放到事务里之后,第一个事务的命令会先完整执行完,等第二个事务执行时读到的库存就已经是扣减后的结果了,从而避免了超卖。
需要注意的两点:
- redis按集群模式部署时,事务的能力会受到很大限制,事务中涉及的所有key必须落在同一个节点(同一个slot)上,跨节点的多个key没办法放在一个事务里执行。
- 除了事务,redis还支持lua脚本。lua脚本同样能保证一组操作被打包原子地执行,而且还能在脚本里完成条件判断、循环等复杂逻辑,比事务灵活得多。上面那段"先判断再扣减"的逻辑用lua脚本实现会更自然,实际开发中也更常见。
到此这篇关于redis事务机制详解的文章就介绍到这了,更多相关redis事务机制内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!
赞 (0)
您想发表意见!!点此发布评论


发表评论