
使用Python实现按卷内目录拆分PDF归档册
2人参与 • 2026-09-21 • Python
企业档案室的季度归档有一个固定动作:把这三个月收到的合同、发票按"到件时间"顺序合并成一本归档册,第 1 页放一张卷内文件目录,后面按目录登记的页段排正文。到件时间是不受控的——发票先到就排在前面,合同后到就排在后面,同一份合同的两页正文还可能被别的文件隔开。
这本册子在归档环节是够用的,一旦要查阅就显出问题。想拿一份完整的合同档案,得先在目录页找到合同编号,记下页段,再翻到对应页;关联的发票散在几百页之外,必须再回目录页查一次关联编号。更棘手的是缺件:某份合同还没收到发票,正文页本身看不出任何异常,只能靠人逐条比对目录里的关联编号。
本文用 free spire.pdf for python 把这件事做成一条流水线。出发点是不数页码,读目录:把第 1 页的卷内目录解析成结构化记录,再按记录把页段从原册中取出、按"合同在前、发票在后"重排成一份独立的归档件。整条流水线最终产出三类文件——按合同拆出的归档件、按季度合并的合订本,以及一份可核对的处理报告,三者页数互相对得上。
本文使用的库可以通过 pip 安装:
pip install spire.pdf.free
文中用到的示例归档册 项目资料归档册_2026q3.pdf 共 8 页,混装了 3 份合同和 2 张发票,其中一份合同尚未收到发票。示例文档与拆分产物都可以直接打开对照本文的每一步。
拆分之前:先读目录,而不是先数页码
整条流水线的入口是卷内目录。目录页上的每一行是一条著录记录,格式固定为:
件号 | 文件编号 | 文件类型 | 页段 | 关联编号
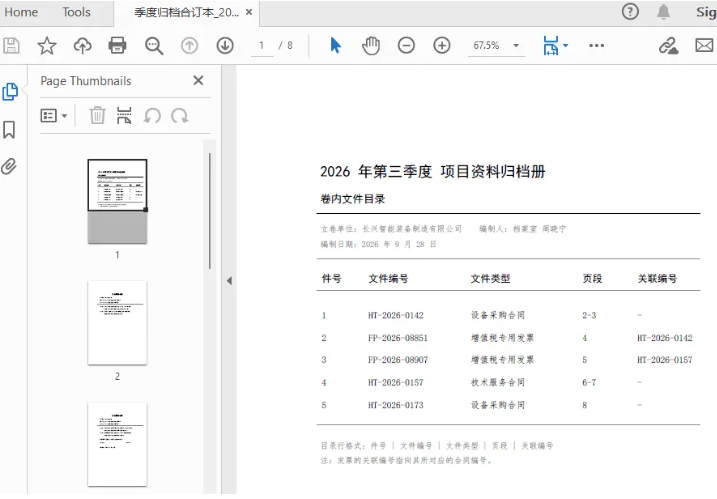
示例册的目录页里登记了 5 条著录。每行拆成五个字段之后是这样:
件号 | 文件编号 | 文件类型 | 页段 | 关联编号
1 | ht-2026-0142 | 设备采购合同 | 2-3 | -
2 | fp-2026-08851 | 增值税专用发票 | 4 | ht-2026-0142
3 | fp-2026-08907 | 增值税专用发票 | 5 | ht-2026-0157
4 | ht-2026-0157 | 技术服务合同 | 6-7 | -
5 | ht-2026-0173 | 设备采购合同 | 8 | -
读目录有两个作用。一是拿到页段,避免靠"数到第几页"猜测边界;二是拿到关联编号——发票行的这一列指向它所属的合同编号,这是判断缺件的唯一依据:一份合同如果在目录里找不到关联编号指向它的发票行,它就是缺件的。
解析部分只需要一页文本和一个正则:
# -*- coding: utf-8 -*-
import os
import re
from spire.pdf import (pdfdocument, pdftextextractor, pdftextextractoptions,
                       pdfmargins, pointf, fileformat, pdfcompressionlevel,
                       pdfimagehelper)

archive = "项目资料归档册_2026q3.pdf"
outdir = "output"
os.makedirs(outdir, exist_ok=true)
row = re.compile(r"^\s*(\d+)\s+((?:ht|fp)-\s+)\s+(\s+)\s+(\d+(?:-\d+)?)\s+(\s+)\s*$")
contract = "合同"


def read_catalog_text(path):
    """目录页固定在第 1 页,这也是唯一需要抽取文本的页面。"""
    doc = pdfdocument()
    doc.loadfromfile(path)
    text = pdftextextractor(doc.pages[0]).extracttext(pdftextextractoptions())
    total = doc.pages.count
    doc.close()
    return text, total


def parse_catalog(text):
    items = []
    for raw in text.splitlines():
        m = row.match(raw)
        if not m:
            continue
        a, _, b = m.group(4).partition("-")          # 页段 "2-3" 拆成起始页与结束页
        items.append({
            "no": m.group(2),                         # 文件编号
            "type": m.group(3),                       # 文件类型
            "pages": list(range(int(a), int(b or a) + 1)),
            "parent": none if m.group(5) == "-" else m.group(5),   # 关联编号
        })
    return items
目录行的分隔符是空白,页段写成 2-3 或单页 4。partition("-") 把页段拆开后,结束页缺失时回退为起始页,这样单页和多页走同一条路径。parent 字段把目录里的"关联编号"原样保留下来,后续判断缺件、判断归属都只看这一个字段。
存好这份结构化记录之后,页段、类型、归属关系就都在内存里了,后面每一步都不再需要回头读 pdf。
交付物一:一份合同一个文件
第一类产物是单份合同的归档件。它的目标是让一份合同档案自洽:合同正文在前,它的发票紧随其后,文件本身就是一个完整可读的单元。
页的取用方式不是"删除不要的页",而是把需要的页复制到一个新文档里:对每一页调用 createtemplate() 得到页模板,再用 draw() 画到新页的坐标原点。新页的尺寸直接沿用原页的 size,页边距设为 0,保证内容不会因为缩放而位移。
def collect(src, phys_pages, phys_to_target, out_path):
    """按物理页序取出页段,在内存中重排到目标页序后保存。"""
    doc = pdfdocument()
    doc.loadfromfile(src)
    out = pdfdocument()
    for n in phys_pages:
        page = out.pages.add(doc.pages[n - 1].size, pdfmargins(0.0))
        doc.pages[n - 1].createtemplate().draw(page, pointf(0.0, 0.0))
    out.pages.rearrange([phys_pages.index(n) for n in phys_to_target])
    out.compressionlevel = pdfcompressionlevel.best
    out.fileinfo.incrementalupdate = false
    helper = pdfimagehelper()
    for i in range(out.pages.count):
        for info in helper.getimagesinfo(out.pages[i]):
            info.trycompressimage()
    out.savetofile(out_path, fileformat.pdf)
    out.close()
    doc.close()
rearrange 的参数是新顺序:传入的列表里,第 i 个元素表示"新文档的第 i 页取用第几页",这里用 phys_pages.index(n) 把目标页号换算成它在页段中的下标。顺序重排只影响页的排列,不影响页内的任何内容。
主循环负责把每份合同和它的发票拼成一个页段列表,并同时判断缺件:
def page_count(path):
    d = pdfdocument()
    d.loadfromfile(path)
    n = d.pages.count
    d.close()
    return n


text, total_pages = read_catalog_text(archive)
catalog = parse_catalog(text)
print("归档册:%s(共 %d 页)" % (os.path.basename(archive), total_pages))
print("卷内目录解析到 %d 条著录:" % len(catalog))
print("件号 | 文件编号 | 文件类型 | 页段 | 关联编号")
for idx, it in enumerate(catalog, 1):
    seg = str(it["pages"][0]) if len(it["pages"]) == 1 else "%d-%d" % (it["pages"][0], it["pages"][-1])
    print("%d | %s | %s | %s | %s" % (idx, it["no"], it["type"], seg, it["parent"] or "-"))

contracts = [i for i in catalog if i["parent"] is none and contract in i["type"]]
print("\n共 %d 份合同,逐份归集:\n" % len(contracts))

made, missing = [], []
for c in contracts:
    invoices = [i for i in catalog if i["parent"] == c["no"]]
    related = sorted([c] + invoices, key=lambda x: x["pages"][0])
    phys = [p for i in related for p in i["pages"]]          # 原册中的物理页序
    target = list(c["pages"]) + [p for i in related if i is not c for p in i["pages"]]
    out = os.path.join(outdir, "归档件_%s.pdf" % c["no"])
    collect(archive, phys, target, out)
    made.append(out)
    if invoices:
        status, note = "完整", "合同 %d 页 + 发票 %d 页" % (len(c["pages"]), len(invoices))
    else:
        status, note = "缺件", "合同 %d 页,未匹配到发票" % len(c["pages"])
        missing.append(c["no"])
    order = "已按合同在前重排" if phys != target else "物理页序即目标页序"
    print("  %-13s %s  %s(%s)→ %s" % (c["no"], status, note, order, os.path.basename(out)))
    print("      物理页序 %s → 目标页序 %s,输出 %d 页" % (phys, target, page_count(out)))
这里 phys 与 target 的区别是关键。phys 是这些页在原册中的实际排列顺序,用作 collect 的取页列表;target 是归档规范要求的顺序——合同页在前、发票页在后。示例册里 ht-2026-0157 的发票(物理第 5 页)先于合同(物理第 6-7 页)到件,两个列表因此不同,档案件在生成时被重排;ht-2026-0142 的到件顺序恰好合规,两个列表一致,不产生任何重排动作。status 与 missing 则由"有没有发票行的关联编号指向本合同"决定,这是整条流水线里唯一的判断分支。
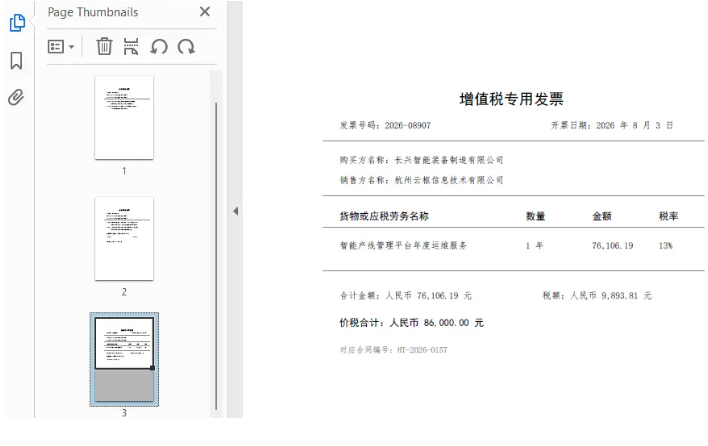
交付物二:季度合订本
第二类产物是把拆分结果重新合并成一本册子,供整季集中归档。合订本的构成是"目录页 + 全部归档件",按文件编号升序排列。
合并用 appendpage 一次追加一个已保存的归档件:
book = os.path.join(outdir, "季度归档合订本_2026q3.pdf")
merged = pdfdocument()
toc = pdfdocument()
toc.loadfromfile(archive)
pg = merged.pages.add(toc.pages[0].size, pdfmargins(0.0))
toc.pages[0].createtemplate().draw(pg, pointf(0.0, 0.0))
parts = [toc]
for out in sorted(made):
    part = pdfdocument()
    part.loadfromfile(out)
    merged.appendpage(part)
    parts.append(part)
merged.compressionlevel = pdfcompressionlevel.best
merged.fileinfo.incrementalupdate = false
merged.savetofile(book, fileformat.pdf)
merged.close()
for part in parts:
    part.close()

print("\n季度归档合订本:%s(%d 页)" % (os.path.basename(book), page_count(book)))
print("缺件提醒:%s" % ("、".join(missing) if missing else "无"))合并阶段有一个容易踩空的地方:appendpage 之后源文档不能立即关闭。如果在追加完成前调用 part.close(),页内容会被提前释放,保存时抛出空引用异常。稳妥做法是把所有被追加的文档对象收集到 parts 列表里,等 merged.savetofile() 返回之后再统一关闭,示例代码里的 parts 就是为此保留的。
合并结果的页数与拆分结果必须严格对得上:8 页 = 1 页目录 + 3 + 3 + 1(三份归档件的页数之和)。页数不相等说明拆分或合并环节丢页,这一步不需要额外校验逻辑,对一次数字即可。
交付物三:处理报告
前两类产物是给档案室归档用的,第三类是给"拆分这件事本身"留凭证的:哪几份合同完整、哪一份缺发票、每个文件各有多少页、首页写的什么。
def first_line(path):
    d = pdfdocument()
    d.loadfromfile(path)
    t = pdftextextractor(d.pages[0]).extracttext(pdftextextractoptions())
    d.close()
    for line in t.splitlines():
        if line.strip():
            return line.strip()
    return ""
lines = ["项目资料归档册拆分结果 2026q3",
         "归档册:%s(%d 页)" % (os.path.basename(archive), total_pages),
         "目录著录 %d 条,合同 %d 份" % (len(catalog), len(contracts)),
         ""]
for out in made:
    lines.append("%-26s %d 页  首页:%s" % (os.path.basename(out), page_count(out), first_line(out)))
lines.append("%-26s %d 页" % (os.path.basename(book), page_count(book)))
lines.append("")
lines.append("缺发票的合同:%s" % ("、".join(missing) if missing else "无"))
open(os.path.join(outdir, "归档处理报告.txt"), "w", encoding="utf-8").write("\n".join(lines))
print("\n处理报告已写出。")
first_line() 复用了前面读目录的抽取方式,只取每份归档件第 1 页的第一行非空文本,用来确认"文件开头确实是合同而不是发票"——这正是重排生效的直接证据。
运行完整流水线后,控制台与报告的内容是一致的:
归档册:项目资料归档册_2026q3.pdf(共 8 页)
卷内目录解析到 5 条著录:
件号 | 文件编号 | 文件类型 | 页段 | 关联编号
1 | ht-2026-0142 | 设备采购合同 | 2-3 | -
2 | fp-2026-08851 | 增值税专用发票 | 4 | ht-2026-0142
3 | fp-2026-08907 | 增值税专用发票 | 5 | ht-2026-0157
4 | ht-2026-0157 | 技术服务合同 | 6-7 | -
5 | ht-2026-0173 | 设备采购合同 | 8 | -
共 3 份合同,逐份归集:
  ht-2026-0142  完整  合同 2 页 + 发票 1 页(物理页序即目标页序)→ 归档件_ht-2026-0142.pdf
      物理页序 [2, 3, 4] → 目标页序 [2, 3, 4],输出 3 页
  ht-2026-0157  完整  合同 2 页 + 发票 1 页(已按合同在前重排)→ 归档件_ht-2026-0157.pdf
      物理页序 [5, 6, 7] → 目标页序 [6, 7, 5],输出 3 页
  ht-2026-0173  缺件  合同 1 页,未匹配到发票(物理页序即目标页序)→ 归档件_ht-2026-0173.pdf
      物理页序 [8] → 目标页序 [8],输出 1 页
季度归档合订本:季度归档合订本_2026q3.pdf(8 页)
缺件提醒:ht-2026-0173
处理报告已写出。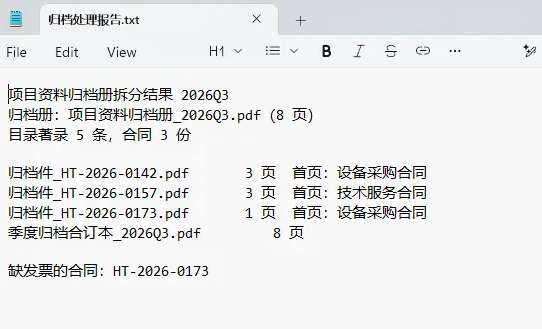
一份合同缺发票这件事,如果只做页拆分是发现不了的——它需要目录里的关联编号参与判断。把缺件提醒写进报告,归档人员拿到的就不只是拆分结果,还有一份"这季归档还不完整"的待办清单。
pdf 页操作相关的类与成员
| 类 / 成员 | 作用 |
|---|---|
pdfdocument.loadfromfile | 加载归档册或已保存的归档件 |
pdfdocument.pages | 页集合,count 取页数,add(size, pdfmargins) 追加空白页 |
pdfpagebase.createtemplate | 把一页的视觉内容封装成可复用的页模板,配合 draw 完成页复制 |
pdfpagebase.size | 页尺寸,复制时用它保持新页与原页一致 |
pdfpagecollection.rearrange | 按给定顺序重排页,参数是"新顺序中各页取用的原下标" |
pdfdocument.appendpage | 把另一个文档的全部页追加到当前文档末尾 |
pdfdocument.compressionlevel | 压缩级别,示例用 pdfcompressionlevel.best |
pdfdocument.fileinfo.incrementalupdate | 置 false 让保存写出完整文档而非增量更新 |
pdfimagehelper.getimagesinfo | 枚举页内图像 |
pdfimageinfo.trycompressimage | 逐个尝试压缩图像,减小输出体积 |
pdftextextractor.extracttext | 抽取页面文本,参数需传 pdftextextractoptions() |
pdfmargins / pointf | 页边距与绘制坐标 |
rearrange 与 appendpage 各自来自独立的示例,这里把它们串进同一条流水线:前者处理"单份归档件内部的页序",后者处理"归档件之间的拼接"。两者都只操作页,不触碰页内对象。
适用范围与边界
目录必须落在前 3 页。 free 版对文本抽取有硬性页数上限:对示例册逐页抽取,第 1 至第 3 页分别返回 1017、569、755 个字符,第 4 页起全部返回空串;即使单独只抽第 8 页,结果同样是空串。把整册逆序抽取(先第 8 页再第 1 页),仍然只有第 1-3 页有内容。这说明限制针对的是页码区间,而不是"抽取总量用完"。同一限制也出现在转图上:saveasimage(7) 不报错,但导出的是一张纯白页。因此本方案把机器可读信息全部压在第 1 页的目录上,正文页只作为图像被搬运,不对其做文本校验。
页模板复制搬运的是视觉层。 createtemplate().draw() 复制的是页面的绘制内容,页级的注释、链接、表单字段不会随之迁移。归档件里如果原本带有签章域或书签,需要另外处理。
缺件判定依赖目录字段。 关联编号是这类归档册的登记规范,如果手上的册子没有这一列,缺件判定就失去了依据,只能退回到按金额或日期比对。
页数是自我校验的锚点。 合订本页数应等于目录页数加上各归档件页数之和;单份归档件页数应等于合同页段长度加发票页段长度。两处对不上就说明有页被漏取或重复取用,检查 phys_pages 列表即可定位。
换上下一季度的归档册
这套流程对输入的要求只有两条:目录在第 1 页,且登记格式稳定。换一季的归档册只需替换 archive 常量;文件名前缀(ht- / fp-)和合同类型关键字(合同)按实际登记规则调整正则,其余逻辑不变。
在目录页之外,仍可扩展的方向包括:把处理报告同时写成 csv,便于汇总多个季度的缺件情况;在归档件首页盖上带编号的水印,让拆分产物与原件可追溯;把 collect() 的页段参数改成由外部配置驱动,用于处理非合同类的混装册(如投标文件与资质证明)。这些扩展都不改变本文的核心做法——以目录为唯一事实来源,让每一步的产出都能被页数核对。
以上就是使用python实现按卷内目录拆分pdf归档册的详细内容,更多关于python按目录拆分pdf的资料请关注代码网其它相关文章!
赞 (0)
您想发表意见!!点此发布评论
发表评论