
Redis 数据结构详解之从五种基础到四种高级
86人参与 • 2026-09-22 • Redis
redis 之所以强大,不只是因为快,更因为它提供了丰富的数据结构——就像仓库里不同形状的收纳盒,各有各的用处,选对了事半功倍。
五种核心数据类型
string
最基本的类型,一个 key 对应一个 value,二进制安全,能存文本、数字、序列化对象,理论上限 512mb。
- 典型场景:缓存用户会话、页面数据;计数器(文章阅读量、点赞数,incr 原子递增);分布式锁(setnx + 过期时间)
- 注意:存复杂对象需要序列化 / 反序列化,有额外开销;大 value 是严重反模式(详见文末大 key 部分)
hash
键值对集合,一个 key 下面挂多个 field-value 对,天然适合存 对象属性。
- 典型场景:用户信息、商品详情——商品 id 作为 key,价格、库存、名称等字段塞进同一个 hash,改单个字段不用整体覆盖
- 注意:小数据量下用压缩列表编码,非常省内存;field 数量超过阈值后会转成哈希表编码
list
有序字符串列表,底层是双向链表(3.2 后改为 quicklist),支持两端快速插入和删除。
- 典型场景:简单消息队列(lpush 生产、rpop 消费);最新消息列表;时间线 feed
- 注意:避免用 lrange 取大范围数据,元素过多时性能下降明显
set
无序且元素不重复的集合,查找和去重效率高,支持交集、并集、差集运算。
- 典型场景:标签系统;独立访客(uv)统计;共同关注、共同好友等社交关系计算
- 注意:集合运算(sinter、sunion)在大集合上耗时较长,要注意使用场景
zset(sorted set)
和 set 类似,但每个元素带一个 score 用于排序,有序 set,底层用跳表 + 字典实现,插入和查询都很快。
- 典型场景:排行榜——游戏积分榜、热搜榜,按 score 排序后直接取 top n;带权重的任务队列
- 注意:score 是 double 类型,有精度限制;相同 score 按 member 字典序排列
四种高级数据类型
随着 redis 版本迭代,又陆续加入了四种高级类型,应对更特殊的场景。
bitmap(位图)
用 bit 位存储数据,一个 bit 只有 0 和 1 两种状态,极度节省空间。
- 典型场景:签到打卡、用户在线状态、海量布尔统计——统计 1000 万用户的日活只需要约 1.2mb 空间
- 本质:底层还是 string 类型,只是用位操作来读写
hyperloglog
基数统计算法,用极小的内存(约 12kb)就能统计超大数量级的不重复元素数。
- 典型场景:uv 统计、独立访客计数等不需要精确值的场景
- 注意:有标准误差约 0.81%,追求精确计数不要用;本质也是 string 编码
geo(地理空间)
底层基于 zset 实现,存储 经纬度 信息,支持距离计算和范围查询。
- 典型场景:"附近的人" "附近的商家" 等 lbs 功能,【lbs = location based service,即"基于位置的服务"】
- 注意:地球是球体,距离计算有近似误差,高精度场景需谨慎
stream
redis 5.0 引入的消息流类型,更专业的消息队列方案。
- 典型场景:复杂消息队列、事件溯源、日志收集
- 特点:支持消费者组、消息持久化、消息 id 回溯,更接近 kafka 的模型
底层编码:数据结构背后的数据结构
表面上是九种数据类型,底层实际由更少的编码结构组合而成。redis 会根据数据量和元素大小自动选择编码,小数据用紧凑结构省内存,大数据切换到高效结构保性能。
三种关键底层结构
ziplist(压缩列表)
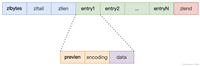
连续内存块组成的紧凑型结构,没有指针开销,非常省空间。小数据量的 list、hash、zset 都用它。
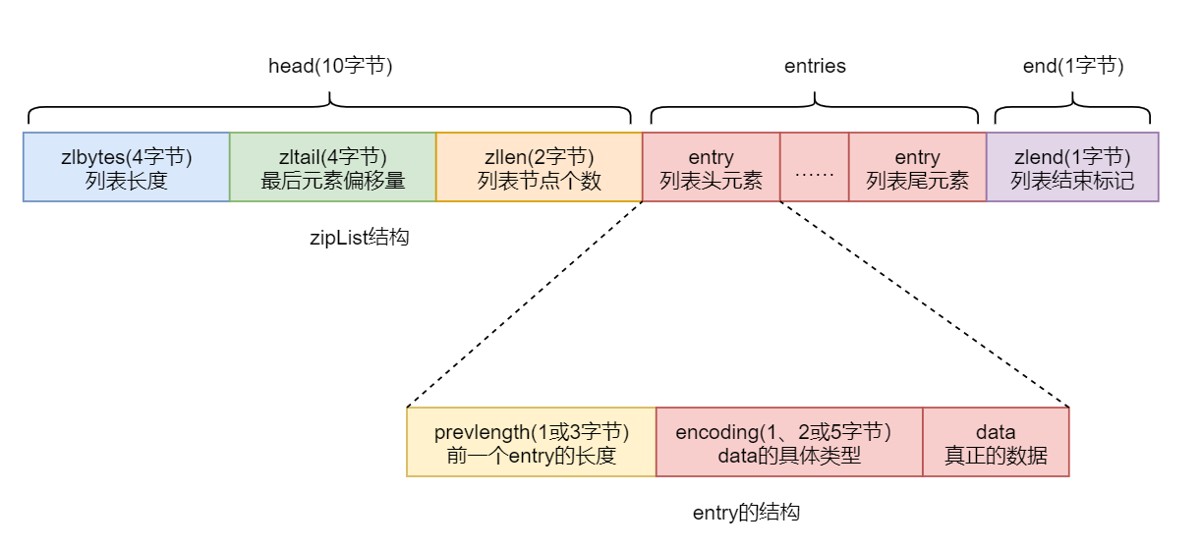
但缺点是插入和删除需要移动内存,数据量大了性能会下降,所以达到阈值后会自动转换编码。
quicklist(快速列表)
redis 3.2 之后 list 的默认实现,可以理解为"链表 + 压缩列表"的混合体——每个链表节点是一个 ziplist,既保留了 ziplist 的内存效率,又减少了普通双向链表的内存碎片和指针开销。
skiplist(跳跃表)
zset 的核心结构,在有序链表基础上增加了多层索引,把查找效率从 o(n) 提升到 o(log n)。配合一个字典用来做 o(1) 的成员查找,两者数据共享不重复存储。
编码自动转换
以 zset 为例,默认转换阈值:
- 元素数量 ≤ 128 且每个元素大小 ≤ 64 字节 → 用 ziplist
- 任一条件超出 → 转成 skiplist + dict
hash 和 list 也有类似的自动转换机制,阈值都可以在配置文件里调整。
选型对比:这个需求该用哪种?
需求场景 | 推荐类型 | 为什么选它 |
|---|---|---|
存单个值、计数器、分布式锁 | string | 最简单直接,原子操作可靠 |
存对象的多个属性,经常修改单个字段 | hash | 字段级操作,不需要整体序列化 |
消息队列、最新列表、按顺序存取 | list / stream | list 简单够用,stream 功能更全 |
去重、标签、共同好友、集合运算 | set | 天然去重,集合运算高效 |
排行榜、带排序的集合 | zset | 按 score 排序,范围查询方便 |
签到、在线状态、海量布尔标记 | bitmap | 极度省空间,位运算高效 |
统计 uv、独立访客(不要求精确) | hyperloglog | 12kb 搞定亿级基数统计 |
附近的人、地理位置查询 | geo | 内置经纬度存储和距离计算 |
生产环境红线:警惕大 key
虽然 string 理论上限 512mb,但生产环境存大 value 是严重的反模式。大 key 不只是 string 的问题,集合类型元素过多同样危险。
大 key 判定标准
数据类型 | 大 key 阈值 | 主要风险 |
|---|---|---|
string | value > 10kb | 网络传输延迟,阻塞其他请求 |
hash / set / zset | 元素数量 > 5,000 | hgetall / smembers 全量操作阻塞 |
list | 元素数量 > 10,000 | lrange 大范围操作耗时 |
stream | 消息数量 > 10,000 | xrange 遍历性能下降 |
大 key 的四大危害
- 命令阻塞:redis 单线程模型,一个大 key 操作慢了,后面所有请求都得等
- 网络瓶颈:大 value 传输占带宽,一次 get 可能就是几十上百兆流量
- 集群倾斜:大 key 集中在某个分片,导致节点负载不均
- 持久化卡顿:bgsave / aof 重写时 fork 大 key 耗时长,可能引发阻塞
治理思路
- 拆分:大对象拆成多个小 key 分片存储;大集合按业务维度(如按日期、按用户)拆分
- 压缩:value 先压缩再存(如 gzip、snappy),用 cpu 换空间
- 冷热分离:热数据留 redis,冷数据下沉到 mysql / es 等持久化存储
- 定期巡检:用
redis-cli --bigkeys或memory usage定期扫描发现大 key
redis 的数据类型看似只是"存东西的不同方式",实际上每种都对应着一类问题的最优解。理解了底层编码和选型逻辑,才能在项目里更好地用 redis。
到此这篇关于redis 数据结构详解之从五种基础到四种高级的文章就介绍到这了,更多相关redis 数据结构内容请搜索代码网以前的文章或继续浏览下面的相关文章希望大家以后多多支持代码网!
赞 (0)
您想发表意见!!点此发布评论
发表评论